AIクローラー運用: CloudflareとOpenAIボットをGEO基準で分ける
AI検索、エージェント、学習クローラーが分かれ始める中で、どのボットを許可し、どれを制限すべきかをGEO運用の視点で整理します。
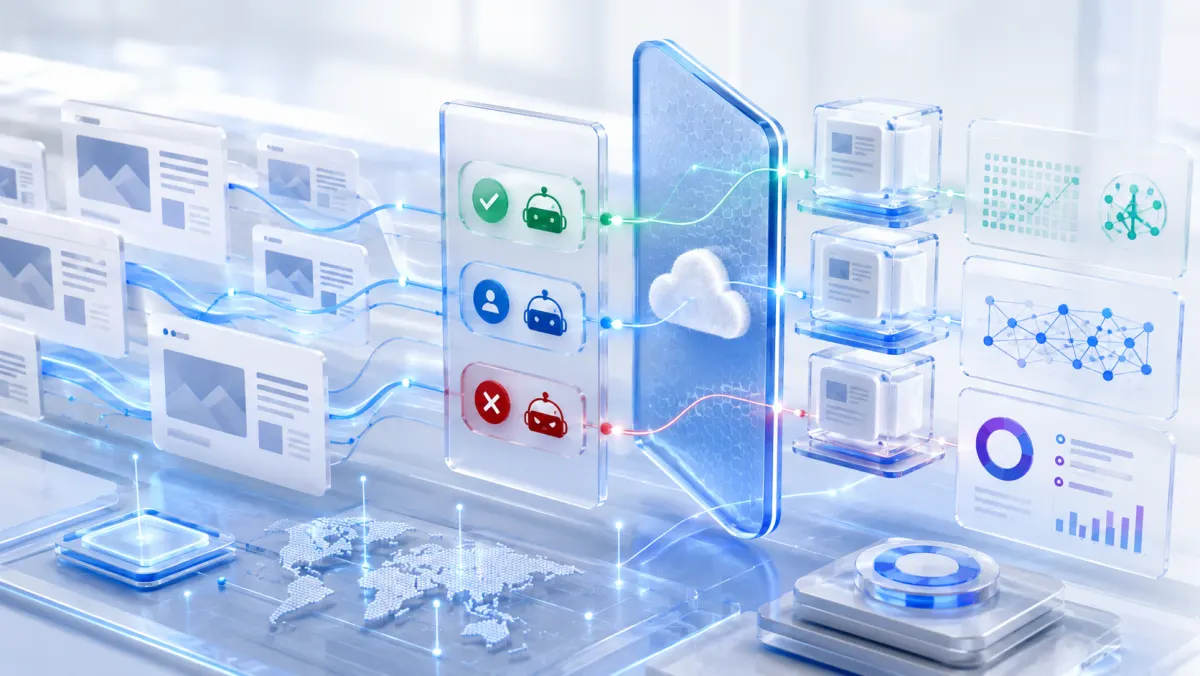
AIクローラー方針は、もう許可かブロックだけでは整理できません。検索露出を支えるボット、ユーザーに代わって動くエージェント、学習用クローラーを分け、GEOでは発見されやすさとコンテンツ保護を同時に管理します。
- Cloudflareは2026年7月にSearch、Agent、TrainingというAIトラフィック分類を示し、2026年9月15日から新規ドメインの一部条件でTrainingとAgentをブロックし、Searchは許可する初期設定を予告しました。
- OpenAIはOAI-SearchBot、OAI-AdsBot、GPTBotを分けています。ChatGPT検索に表示されたい場合はOAI-SearchBotを許可し、学習利用を制限したい場合はGPTBotを別に管理します。
- GEO運用ではrobots.txtだけでなく、CDN規則、sitemap/RSS、引用候補URL、ボットログ、記事→料金ページ遷移を同じ流れで見ます。
CloudflareはAIトラフィックをSearch、Agent、Trainingの用途で説明し、多目的クローラーも該当する目的ごとに追跡すべきだと述べています。
OpenAI文書は、OAI-SearchBotをChatGPT検索でのサイト表示に使うボット、GPTBotを基盤モデル学習に使われる可能性があるコンテンツクローラーとして分けています。
GoogleはAI OverviewsやAI Modeの補助リンク候補になるには、ページがインデックスされ、スニペット表示対象であり、robots.txtやCDN、ホスティングでクロールが許可されている必要があると案内しています。
1. AIボットを1つのグループにするとGEO機会を失う
以前は、検索エンジンボットと悪性ボットを分ければ十分でした。今はそうではありません。Cloudflareは2026年7月、AIトラフィックをSearch、Agent、Trainingの3用途で説明しました。Searchは後で質問に答えるために収集やインデックスを行い、Agentはユーザーのためにリアルタイムで作業し、Trainingはモデル学習や微調整にコンテンツを使います。
GEOで最も危険なのは、AIボットをすべてブロックすることです。学習利用を防ぎたい意図は自然ですが、検索目的のボットまで止めると、ChatGPT検索やAI回答エンジンで発見される機会も減ります。一方ですべて許可すると、独自コンテンツや広告ランディングページが過剰に再利用されるリスクがあります。
そのため、方針の単位はボット名だけでなく目的にします。同じ会社でも検索、広告審査、ユーザー要求、学習で別の仕組みを使う場合があります。目的別の規則なら、可視性と保護を同時に調整できます。
- Search: AI回答での引用と発見につながるため、基本は許可候補にする。
- Agent: ユーザーの代理で動くため、範囲とレート制限を別に確認する。
- Training: 学習利用を制限したい場合は、robotsとCDN方針を分ける。
- Ads verification: 一般検索ボットとは別のログで管理する。
2. OpenAIボットは検索露出と学習制限を分けて判断する
OpenAI文書は、OAI-SearchBotとGPTBotの目的を分けています。OAI-SearchBotはChatGPT検索機能でウェブサイトを表示するために使われます。GPTBotは生成AI基盤モデルの学習に使われる可能性があるコンテンツをクロールします。この2つを同じ規則にすると、必要な検索露出と不要な学習利用の制限を同時に管理しにくくなります。
実務上の方針は明快です。ChatGPT検索で発見されたいならOAI-SearchBotを許可します。学習利用を制限したいならGPTBotを別に管理します。広告を運用する場合は、ChatGPT広告のランディングページ審査に使われるOAI-AdsBotも別の分類にします。
この区別はGEO診断で重要です。検索ボットをブロックしたまま「AI検索に出ない」と考えると、原因分析がずれます。逆に学習ボットを許可しただけで可視性が上がったと見るのも不正確です。目的、方針、ログ、引用候補状態を一緒に確認します。
- OAI-SearchBot: ChatGPT検索での可視性を望むなら許可候補。
- GPTBot: 学習利用を制限したい場合は別途Disallowを検討。
- OAI-AdsBot: 広告ランディングページ審査ログと接続。
- ChatGPT-User: ユーザー要求ベースのアクセスとして扱い、Search opt-out判断には使わない。
3. Cloudflare方針はrobots.txtの外側まで広がる
robots.txtは今も重要ですが、それだけでは足りません。GoogleはAI機能での表示にも、robots.txtだけでなくCDNやホスティング側でクロールが許可されていることが重要だと説明しています。CDNレベルで止めていれば、robots.txtが許可でも実際のリクエストは届きません。
Cloudflareは2025年にPay Per Crawlを公開し、サイト所有者がクローラーごとにAllow、Charge、Blockを選べる方向を示しました。2026年にはSearch、Agent、Trainingの目的別管理、Crawler Hints、Pay Per Use実験へ話題を広げています。重要なのは、全ブロックではなく価値交換を生むアクセスを見分けることです。
GEO GatewayをCloudflareの背後で動かす場合、最低でも3層を見ます。robots.txtのuser-agent方針、CloudflareのAI BotまたはWAF規則、そしてアプリが返す記事別HTMLとsitemap/RSSです。1つでもずれると、検索ボットがURLを発見できなかったり、AI回答候補として十分な根拠を読めなかったりします。
- robots.txtとCloudflare AIトラフィック設定を同じ目的分類でそろえる。
- 公開ランディングとガイドはSearch目的ボットを許可する。
- 広告ページ、決済、内部ダッシュボードはAgentとTrainingを別に制限する。
- 規則変更後、ログで200、403、402応答を確認する。
4. GEOダッシュボードには方針と転換データを一緒に残す
AIクローラー方針は、セキュリティ設定で終わらせません。どのボットがどのURLにアクセスし、そのURLが検索やAI回答候補につながったか、さらに読者が代表ガイドや料金ページへ進んだかを接続して見ます。
OAI-SearchBotを許可してもブログURLへのアクセスがない場合は、sitemap、RSS、内部リンク、DNS、CDNキャッシュを確認します。アクセスはあるのに検索流入や引用候補がない場合は、記事構造、本文根拠、schema、titleを見ます。検索流入はあるのに転換が弱ければ、CTAと料金説明を見直します。
GEOの目標は、すべてのAIアクセスを増やすことではありません。検索可視性に必要なアクセスは開き、学習や自動化リスクの高いアクセスは制限し、その結果が実際の流入と転換につながるかを測ることです。この基準があれば、CloudflareとRailway上でもブログを安定したマーケティング資産として運用できます。
- URL別のボットアクセスログとrobots/CDN方針変更を一緒に記録する。
- 検索ボットアクセス後、sitemap反映、引用候補、非ブランド露出を追う。
- 記事→代表ガイド、記事→料金ページ、記事→7日無料開始を分ける。
- ボット許可拡大は、測定可能な運用実験として扱う。
この記事のチェックリストを最初のAI Viewに適用しましょう。
7日間、AI View作成、AIリクエストのモニタリング、流入からコンバージョンまでの追跡をGEO Gatewayで確認できます。
7日間無料で始める